Spring Boot 4.0 分库分表:路由、扩容与跨库查询
前言
单表数据量继续增长后,索引变大、备份变慢、DDL 窗口变长。分片把一部分数据放到另一张表或另一个数据库,但会换来新的复杂度:
- 每条查询必须能确定目标分片。
- 跨分片查询需要聚合。
- 扩容会改变路由,历史数据要迁移。
- 唯一 ID、事务和分页都更困难。
本章实现两分片订单路由。为了让示例可以直接运行,两个分片放在同一 PostgreSQL 的不同表中;物理分库时,只需把每条 SQL 使用的 JdbcTemplate 换成对应数据库。
配套源码:dvsusan/spring-boot4-demo。
最终结果
创建订单:
curl -X POST \
  "http://localhost:8080/api/v1/db/shards/orders?customerNo=C6001&amount=199.00"
响应会带 shard:
{
  "code": "0",
  "message": "success",
  "data": {
    "orderNo": "SH8DC148001E6A20",
    "customerNo": "C6001",
    "amount": 199.00,
    "status": "CREATED",
    "shard": 0
  }
}
按订单号查询只访问计算出来的一个分片;按客户查询需要扫描两个分片并归并结果。
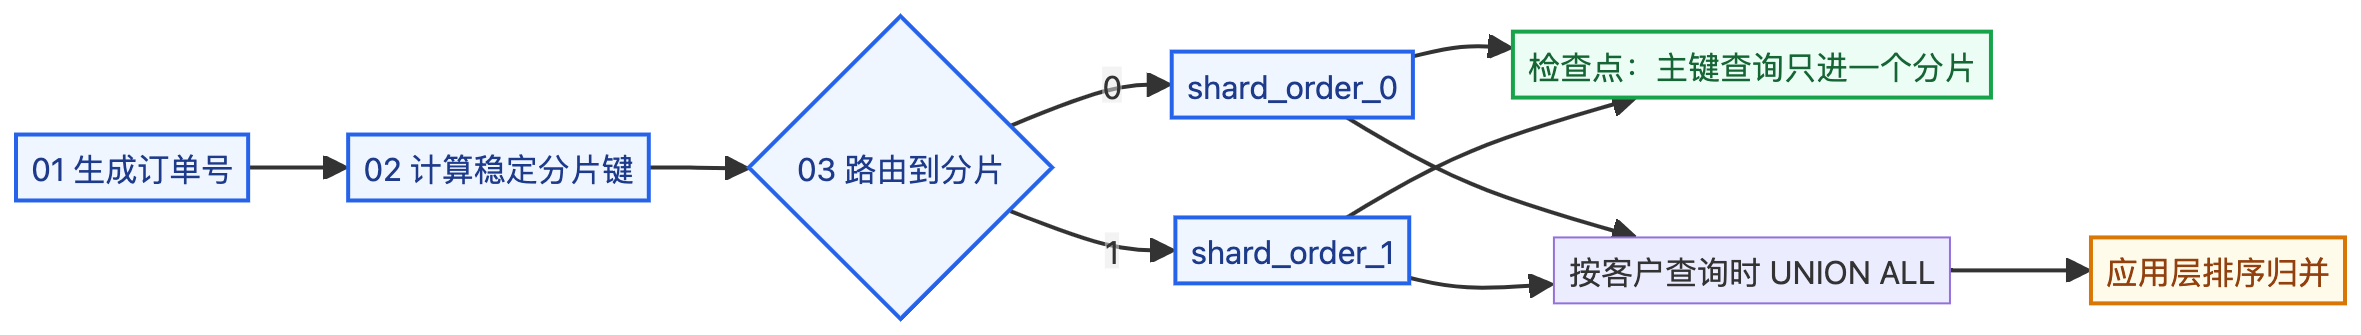
图 1:单分片路径必须稳定且低成本;跨分片只能在确有业务需求时引入。
第 1 步:先判断是否真的需要分片
出现以下信号时再评估:
- 单表数据量已经让索引和备份难以维护。
- 单库写入或连接数成为明确瓶颈。
- 业务可以找到稳定的分片键。
- 大部分查询能带上分片键。
只是“听说大厂都分库分表”就提前拆,通常会让事务、报表和运维复杂度远远超过收益。
订单系统常用分片键:
tenant_id:适合租户天然隔离,但大租户可能倾斜。customer_no:同一客户订单落在一个分片,查询方便。order_no:分布均匀,但客户列表查询需要广播。
本章选择 order_no,因为主键查询是最高频路径。代价是按客户查询要跨分片。
第 2 步:创建两个分片表
Flyway V3:
-- 教学项目用同一数据库中的两张表模拟两个物理分片。
CREATE TABLE shard_order_0 (
    id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    order_no VARCHAR(32) NOT NULL UNIQUE,
    tenant_id VARCHAR(32) NOT NULL,
    customer_no VARCHAR(32) NOT NULL,
    amount NUMERIC(12, 2) NOT NULL,
    status VARCHAR(32) NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE shard_order_1 (
    id BIGINT GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    order_no VARCHAR(32) NOT NULL UNIQUE,
    tenant_id VARCHAR(32) NOT NULL,
    customer_no VARCHAR(32) NOT NULL,
    amount NUMERIC(12, 2) NOT NULL,
    status VARCHAR(32) NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT CURRENT_TIMESTAMP
);
两张表结构必须完全一致。索引、字符集或字段长度不一致,会在扩容和迁移时产生隐蔽问题。
第 3 步:实现稳定路由
public int route(String orderNo) {
    // floorMod 保证负数哈希也能得到 0 或 1。
    return Math.floorMod(orderNo.hashCode(), 2);
}

private String tableName(int shard) {
    return switch (shard) {
        case 0 -> "shard_order_0";
        case 1 -> "shard_order_1";
        default -> throw new IllegalArgumentException(
                "非法分片: " + shard
        );
    };
}
表名只来自内部枚举结果,不能把客户端字符串直接拼进 SQL。
Java String.hashCode 适合教学和普通均匀分布,但跨语言、跨版本路由或扩容时,最好使用明确版本化的哈希算法,并保存路由版本。
第 4 步:写入单分片
// 先根据订单号确定分片,再写入对应物理表。
String orderNo = "SH" + UUID.randomUUID()
        .toString()
        .replace("-", "")
        .substring(0, 14)
        .toUpperCase(Locale.ROOT);
int shard = route(orderNo);

jdbcTemplate.update("""
        INSERT INTO %s
            (order_no, tenant_id, customer_no, amount, status, created_at)
        VALUES (?, ?, ?, ?, 'CREATED', CURRENT_TIMESTAMP)
        """.formatted(tableName(shard)),
        orderNo,
        tenantId,
        customerNo,
        amount);
.formatted(tableName(shard)) 只插入安全带路由出来的物理表名,业务值仍使用 ? 参数。
第 5 步:主键查询只进一个分片
// 主键查询只访问路由计算出的那个分片。
public ShardOrderView findByOrderNo(String tenantId, String orderNo) {
    int shard = route(orderNo);
    return jdbcTemplate.queryForObject("""
            SELECT order_no, customer_no, amount, status, created_at
            FROM %s
            WHERE tenant_id = ? AND order_no = ?
            """.formatted(tableName(shard)),
            (resultSet, rowNum) -> map(resultSet, shard),
            tenantId,
            orderNo);
}
如果这里先查路由表,再多一次数据库访问,就失去哈希路由的意义。只有当分片规则经常变化或需要迁移时,才引入持久化路由映射。
第 6 步:处理跨分片查询
按客户查询:
// 没有分片键的客户查询需要访问全部分片。
return jdbcTemplate.query("""
        SELECT *
        FROM (
            SELECT order_no, customer_no, amount, status, created_at
            FROM shard_order_0
            WHERE tenant_id = ? AND customer_no = ?
            UNION ALL
            SELECT order_no, customer_no, amount, status, created_at
            FROM shard_order_1
            WHERE tenant_id = ? AND customer_no = ?
        ) shard_result
        ORDER BY created_at DESC, order_no DESC
        """, mapper,
        tenantId, customerNo,
        tenantId, customerNo);
同一数据库中可以用 UNION ALL。物理分库时通常要并发查询每个分片,再在应用层归并和分页。
跨分片分页不能只在每个分片取第一页。正确做法是每片取前 offset + size 条,汇总排序后再截取,并严密限制最大偏移。
第 7 步:验证路由
启动 db Profile,创建两笔订单:
curl -X POST \
  "http://localhost:8080/api/v1/db/shards/orders?customerNo=C6001&amount=10.00"

curl -X POST \
  "http://localhost:8080/api/v1/db/shards/orders?customerNo=C6001&amount=20.00"
按客户查询:
curl "http://localhost:8080/api/v1/db/shards/orders?customerNo=C6001"返回结果可能来自两个分片,但排序应是 created_at DESC, order_no DESC 的全局顺序。
自动化测试 ShardingAndTenantRoutingTest 会验证:
- 创建后能按订单号找回。
- 返回的分片号与路由计算一致。
- 客户查询能聚合两个分片。
mvn test第 8 步:规划扩容
从 2 片扩到 4 片时,hash % 2 会变成 hash % 4,大部分数据都要移动。可选方案:
- 成倍扩容并成对拆分,降低迁移比例。
- 一致性哈希或虚拟槽位。
- 保存显式路由表,支持灰度迁移。
- 双写新旧分片,校验后切换读流量。
迁移步骤:
- 建新分片并校验 Schema。
- 记录旧分片变更位点。
- 全量复制历史数据。
- 增量双写或订阅变更。
- 校验数量、金额和抽样内容。
- 灰度切读。
- 稳定后停止旧写入并归档。
常见问题排查
| 现象 | 常见原因 | 处理方式 |
|---|---|---|
| 主键查询找不到订单 | 路由算法或分片数变化 | 固定算法版本并记录路由 |
| 数据严重倾斜 | 分片键分布不均 | 换键、加盐或虚拟槽位 |
| 客户列表很慢 | 每次扫描所有分片 | 按客户分片或维护查询索引 |
| 跨片分页重复/缺失 | 每片独立分页 | 全局归并后再切页 |
| 扩容后历史数据丢失 | 只改路由没迁移旧数据 | 双写、回填和校验 |
| SQL 拼接风险 | 用户输入直接做表名 | 表名只由内部路由枚举产生 |
本章小结
分片不能只看写入吞吐,还要看查询路径:
- 选一个高频查询能命中的分片键。
- 单分片查询保持简单。
- 跨分片查询要限制范围和成本。
- 扩容前设计迁移与路由版本。
只有单库确实无法承受时,分片才是合理选择。
练习题
把路由升级为 8 个虚拟槽位:
- 槽位
hash % 8。 - 初始映射到两个物理分片。
- 扩容时只迁移部分槽位。
- 为每条订单记录当前路由版本。
- 设计迁移失败后的读回退策略。
上一节:PostgreSQL JSONB、索引与全文检索
返回课程目录
相关阅读:
13 个企业级实战项目 · 源码 + 教程 + 答疑
简历包装指导AI Agent 实战高并发·微服务Offer 导向持续更新3000+ 同行交流1V1 答疑3 天包退
覆盖高并发、微服务、分布式与 AI Agent:100万QPS短链、企业智能知识库、商城微服务、SaaS点餐、秒杀、刷题小程序、代码生成器、AI Agent 等。券后 ¥129(原价 ¥159),不满意 3 天包退。